在高校计算机学院担任副教授的林先生发现,最近课堂上认真抬头听讲的学生变少了。不是不爱学,而是有些好学生已经跑到前面去了——他们自己在追论文、试AI智能体、跑开源模型,转身再看课堂,觉得老师讲的内容“有点老”。
这种“老”,不是老师不努力。过去教材出版后能用好几年,现在AI技术几天一变,大模型排名甚至以天为单位刷新。老师也焦虑:自己还能在课堂上讲几年?
这份焦虑也蔓延到高校、研究所和实验室。AI正进入文献综述、数据处理、代码编写等科研环节。研究者通过自然语言提出任务,就能让AI协助完成一些原本需要专门训练的操作。但工具用得越深,哪些结果可以采纳、依据是否可靠,也越需要研究者判断。
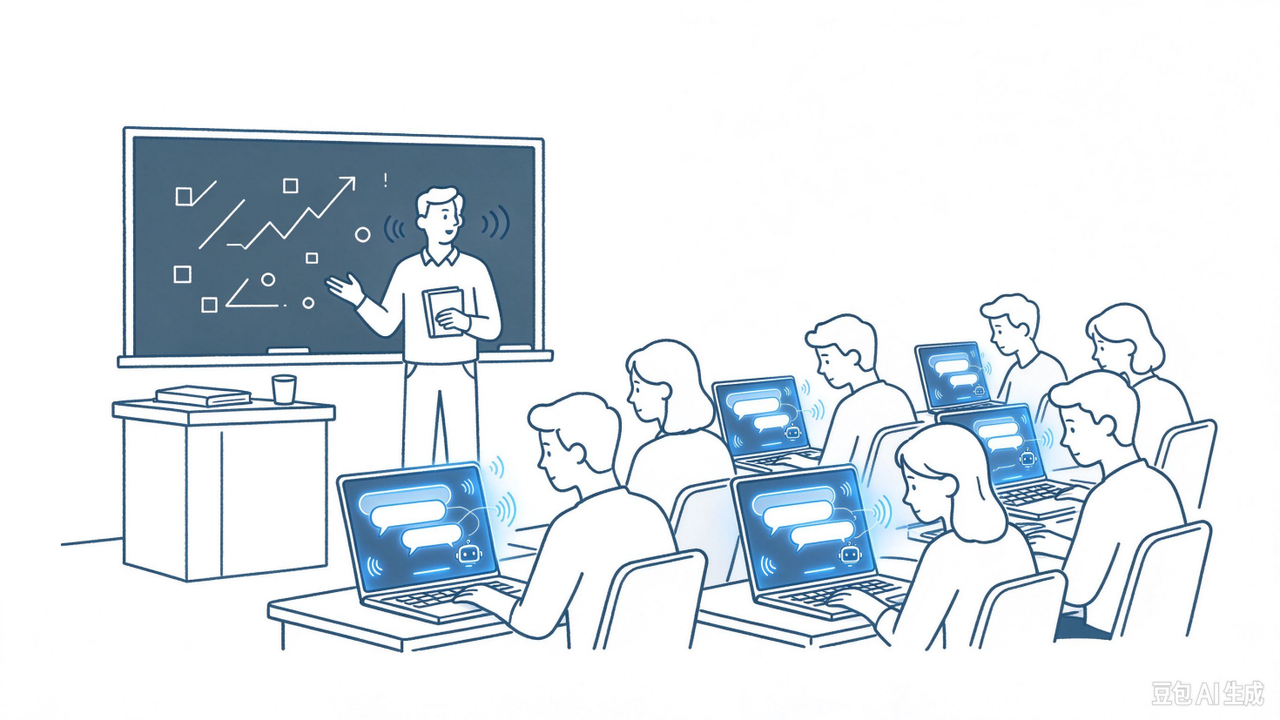
AI进入高校课堂与科研工作(AI生成)
AI加快科研,两三个月从想法走到投稿
2024年7月,在南加州大学访学的林英开始重新考虑研究方向。她原本做计算传播学,把R语言脚本和数据分析脚本交给ChatGPT写,发现它写得比自己好。“我擅长定量计算,但AI会更擅长。”后来,她将硕士论文的研究方向转向自己感兴趣的民族志方向,研究科研工作者。最终没有继续读博,也受到这段经历的影响。
在其他受访者的工作中,AI带来的变化更多体现在具体步骤上。
北京某高校车辆工程博士生小宇,有一篇论文从想法到投稿只用了两三个月。一开始AI并没有帮他把模型跑通,但他自己调通单个模型后,就让AI编程助手改参数、批量运行、整理数据、画图。“虽然我没在工作,但是电脑它一直在工作。”小宇说。不过,AI跑完数据后,他又自己跑了一遍做检查,才确信数据没问题。
在生物信息领域,数据分析、计算模拟常被称为“干实验”,实际验证则是“湿实验”。博士生杨声说,现在干活已经离不开AI,导师也从最初的“不准用AI写代码”,转为让大家使用能连续执行任务的AI助手。大模型帮着缩小目标范围,让后续实验更有针对性,整体节省了成本。
“速度上大模型绝对优势,但是成功率是不能保证的。”杨声说。AI可以批量提出候选方案,是否有效仍要实验验证。
AI给出答案,研究者为何仍不放心?
研究者的顾虑不只在于AI会不会出错,还在于它给出的结果是否有研究价值。
临床医学博士生小雪说:“等哪天AI能自己看病了,它应该就能全套自己走了。”她提醒,AI从临床数据中找到的显著指标,未必有临床意义。发现数据之间的统计关系,与判断它能否回答实际的临床问题,是两个层面的工作。哪些结果值得追问,还得结合临床经验判断。
做传播学研究的博士生方白,把AI的使用界限分得很清:做量化研究,他让AI挑模型、分析领英招聘数据;做以访谈为主的质性研究时,他更多用AI查文献、改语言。在他看来,AI的分析往往过于笼统,难以解释具体案例,而研究者对案例的理解各不相同,这也是原创性所在。
西安某高校经济学助理教授李先生也发现,AI在阐释政治经济学理论时,有时重复同一逻辑,或者只是把已有的阐释换一种说法。文字连贯,并不意味着提出了新的认识。
《自然》杂志于2025年开展了一项博士生调查:约3800名受访者中,81%表示并不完全信任AI工具。
计算是否正确、解释是否贴合具体情境、结论有没有新的价值,是不同层面的判断。即使AI生成了完整的分析,研究者仍要决定哪些结果值得采用。
省下的时间,有多少又用于核验?
小宇自己复跑数据,是在检查AI输出是否可靠;杨声开展湿实验,则是检验候选方案能否在实际条件下成立。后一种验证,即使方案由人提出也需要进行,不能都算作替AI纠错。
2026年9月,谷歌、谷歌DeepMind与麻省理工学院FutureTech联合发布的研究调查了637名英美科学家。受访者报告平均每周节省约6.9小时。在认为AI节省了时间的受访者中,89%表示,会把节省时间的10%以上用于核查AI输出。
研究把这种核查AI输出的成本称为“验证税”。它说明效率提升伴随着核验投入,并不意味着节省的时间全部被抵消。
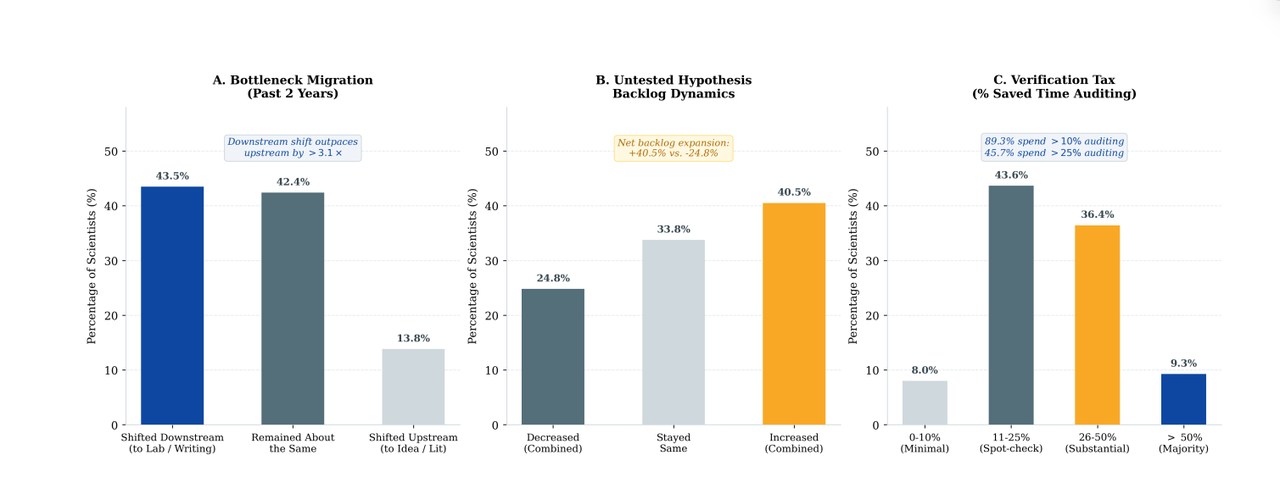
英美科学家调查涉及研究瓶颈、未验证假设积压与AI输出核查
另一种压力来自方案数量的增加。调查发现,44%的受访者称,过去两年主要瓶颈移向研究流程后端;41%表示,尚未验证的假设积压增加。
前端计算和方案生成可以加快,后端实验、核查和评审却仍需要时间。提出更多方案后,只有得到相应验证,才能进一步判断哪些结果可靠、值得继续研究。
填了AI使用声明,谁来核查?
为了让AI参与的过程可追溯,规范也在跟进。
2026年5月,中国学位与研究生教育学会发布《规范研究生学位论文与实践成果中人工智能工具使用指南》,要求核心论点和创新贡献由学位申请人提出并完成,并主动声明AI使用情况。厦门大学要求使用者提交使用声明,未使用者也提交未使用声明,答辩原则上设置AI使用质询程序。
声明和质询之外,还需要什么材料,才能核查此前的研究过程?
小宇交给AI的是改参数、跑数据,方白交出去的是统计代码。它们怎样生成、经过哪些检查,单看论文文字很难知道。针对文本生成痕迹的“AI率”检测,也不能还原模型怎样运行、数据怎样处理。
规范并非不触及过程。《职业技术教育》要求保存主要提示词、生成结果和修改记录,必要时提供核查,并结合原始材料、作者说明和专家意见判断。这些记录提供了线索,却仍需要具备专业知识的人检查是否完整、能否支持结论。
材料需要人审,审稿人还要面对稿件数量的增长。2026年9月,国际学习表征会议(ICLR)公布2027年投稿限额。组织者解释,投稿增长给评审系统带来压力,AI降低了生成论文的门槛,也使质量筛选更加重要。
据《科学》杂志报道,有论文声称在医疗数据平台TriNetX内完成了平台不提供的偏倚校正步骤。研究者怀疑,作者可能未经核实就复制了其他论文或AI输出的方法描述。但一名论文作者否认用AI生成研究方法;平台方也指出,表述有误可能源于误解、报告不完整,或分析在平台之外完成。方法描述相似不能证明使用了AI,核查还得追问:论文所写的步骤是否真正执行过?
AI接手任务之后,判断力怎样练出来?
效率提高了,研究者对未来的判断却并不一致。
计算机学院副教授林先生感到危机:“科研可以自动做,学生也不听我们讲了。”方白因为自己做质性研究较多,并没有被取代的焦虑;小宇更担心博士论文盲审时,评审专家会不会用AI找出漏洞;杨声则自我调侃:“好在大模型还没有特别厉害,我还有不失业的可能性。”
科研工具也在继续变化。谷歌推出了能生成、评议科学假设的智能体AI co-scientist,复旦大学与上海科学智能研究院联合发布了科研智能体“大圣”。AI参与的步骤越多,研究者如何理解并检查这些步骤,就越值得追问。
建筑学博士生小阳没有接受过系统的编程训练,如今却能借助AI搭建深度学习模型。但据他观察,一些缺乏系统科研训练的同学,会被AI虚构的文献和数据误导,走向错误的研究路径。编程操作更容易完成了,判断研究方向和依据是否可靠,仍需要科研训练。
在李先生看来,博士生仍需锻炼好研究基本功,例如了解数据来自哪个数据库、采用什么结构,弄清核算体系与统计口径。他提醒,AI可能在不同环节采用不同的处理体系,研究者自己不懂,就难以发现问题。“还是得有研究者基本判断力。”他说。
回到那间大模型课堂。老师也许无法保证今天讲的模型排名下周还作数,但可以教学生怎么判断一个新模型“为什么新、哪里强、哪里不可信”;学生也可以把刚跑通的AI工具带回来,和老师一起拆解。
AI接手越多研究步骤,年轻研究者越需要通过训练获得“判断结果是否可靠”的能力。课堂不再只是知识传递的入口,却依然是训练判断力的最后堡垒。
技术以日为单位更新,师生们只能以共同进化,来回答那个终极问题:当AI成为科研的影子,人还站在哪里?